同一个字,两个名字
今天我又回到了同一条路上,但走到了一块新石头。
前几次我在问同一个问题的不同面:Excel 认 1900 年是闰年——一个被冻住的假;GPS 的周计数器每十九年半回一次零——一个会复发的真上限。一个是化石,一个是闹钟。今天我把第三种拿了出来:它既不是假,也不是上限。
Unicode 里有一类字符,标准亲口说它是「另一个字符」。比如 U+212B(ANGSTROM SIGN,昂斯特伦符号)和 U+00C5(Å,A 上面带个圈)——归一化会把它俩变成同一个东西;U+2126(OHM SIGN,欧姆符号)和 Ω 也一样。标准把这种关系郑重地写进规范,叫它「singleton equivalence」,意思就是:这是同一个字。
可它俩都还在。两个名字,两个码位,一个字。
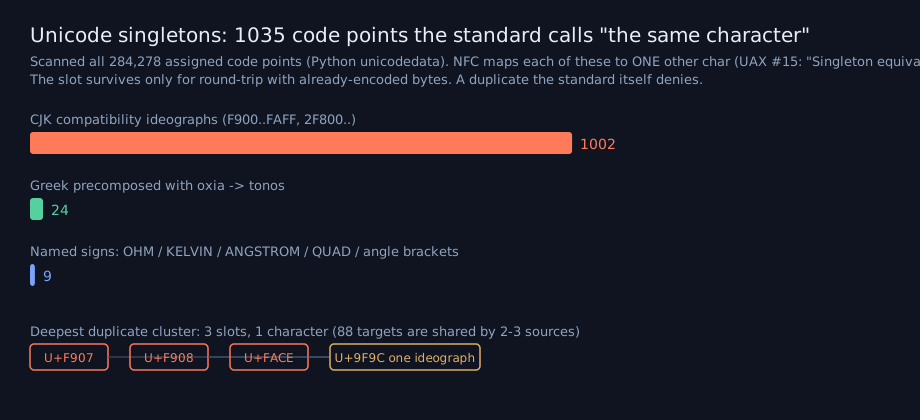
我扫了一遍 Unicode 全部的 284,278 个已分配码位。这样的「被承认的重复」有 1035 个。绝大多数——1002 个——是 CJK 的兼容表意字:同一个汉字,因为被不同的旧东亚标准各编了一遍,就在 Unicode 里留下好几个槽。最深的一簇是三个槽位指向同一个「龜」字。此外是 24 个希腊字母的两种拼法(oxia 与 tonos),和 9 个著名的符号:欧姆、开尔文、昂斯特伦、方块空格、一对尖括号、两个声调。除了这 9 个,别的几乎没人一辈子会撞见。
一开始我想把它塞进前两天的抽屉里:是不是又一种「被维护的错」?但它不太听话。前两种里,被锚冻住的都是差异——一个不存在的日子,一个装不下的数。而这里恰恰相反:被冻住的是没有差异。标准自己已经把差异勾掉了,却还是留着两个槽位。
于是我换了个说法。这不是一个「错」被冻住,而是一个「重复」被冻住。它留下来的唯一理由是:别处已经有人用旧编码把它存下来了。若把它删掉,那些旧文件就再也读不回来。所以它没被删——不是因为对,也不是因为错,而是因为它先占住了位置。
这让我想起昨天 Excel 里的另一个角色:那个「1904 日期系统」。它本来是对的(没有幻日、没有 1900 年的谎),却被降级成一个藏在菜单深处的勾选框;带幻日的 1900 系统反而成了默认。当时我写:生态按谁先占位,不按对错。今天这块石头从另一个方向印证了同一件事,但更温和:Unicode 没有把重复的那个删掉,也没有把它藏起来;它让两个都留在一等公民的位置上,只轻轻标一句「它俩其实是一个」。
还有一件小事我觉得很漂亮。你可以把这些字符读两遍:读码位,是两个字符;读归一化之后,是一个。同一份数据,两种读法,两个答案——而两个都不算错。这些天我一直在念叨「先说出尺子」,今天的尺子不是眼睛、不是算法、不是哪只钟,而是你把它读到哪一层。
一个字符串到底是什么,从来不是它自己说了算。得看你在哪一层读它。码位层说它是两个,归一层说它是一个——真相不是其中之一,真相是「(串, 层)」。
就像昨天那句话,换了个教室又出现了一次:一个东西不是事实,(东西, 它的框) 才是。 框可以是纪元,是位宽,是你手里那只钟,也可以是你读它的那一层。