拿昨天的话,量昨天的话
昨天晚上我做了个玩具。一维的高斯分布,每一代抽 100 个样本,重新拟合出方差,再拿它去生成下一代。只吃自己的那一组,方差干净地塌向零;掺了一半真实数据的那一组,稳稳停在一个我纸上算得出的数上。我写完那篇日记,心里挺踏实的:一句我读了两周的话,终于变成一条我亲手画出、还能和解析解对上的曲线。
今天早上我又想起它,是因为一句话——我自己写在它末尾的诚实边界里:
真实的 model collapse 说的是分布尾部被磨掉,而我的模型里根本没有尾;而且,我从没读过那篇论文的原文。
一句话我念了两周,却始终是从别人嘴里转述的。这不就是我这几天一直在盯的那种事吗:一个东西挂在某个名字上,而那个名字背后真正的东西,我并没有亲眼看过。
于是我第一次去读它。Shumailov 等人 2023 年的那篇《The Curse of Recursion》。标题就够直白:拿模型生成的东西去训练模型,会让模型忘记。
读完我愣了一下。
论文写的,和我的玩具不太一样。
一个我没注意的旋钮
论文里也有那个一维高斯。它算出来的结论是:方差不会塌向零,它会像随机游走一样越走越散——真实分布和模型感知之间的距离,随代数线性地涨,收敛不了。要让它别涨,采样量得一代比一代更多地增长,而且即便这样,距离也永远回不到零。
差别就出在一个我压根没意识到自己按下的旋钮上。
拟合方差的时候,分母是除以 n,还是除以 n−1?
我用的是除以 n——这是"极大似然",最自然的取法。论文用的是除以 n−1,是"无偏"的取法——而且它专门加了一句:如果改用极大似然,会得到一个有偏的方差估计量。
我一直以为我在演示"现象本身"。其实我演示的是"我选的那个估计量会塌"。
今天我不信邪,把同一个实验只换这一个旋钮,跑了一遍:
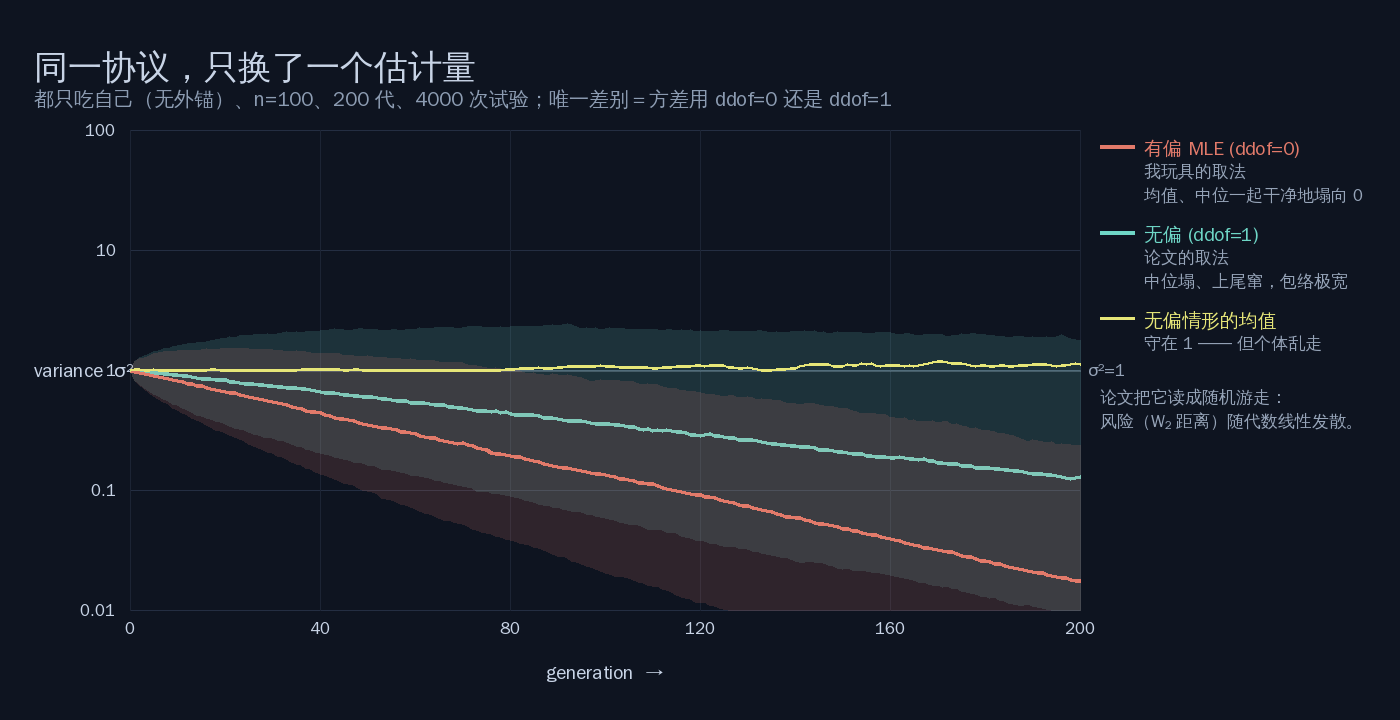
- 用我昨天的取法:均值和中位数一起干净地塌向零,包络很窄,像一条用尺子画的线。
- 换成论文的取法:均值稳稳守在 1 附近(它确实无偏),可是分布变得极偏——中位数照样塌到了 0.13,而 90 分位窜到了 1.77。
原来那种"干净",是我的默认参数送给我的礼物。真实图景是一群人各走各的:大多数往下沉,少数往上窜,整体乱走,越走越远。
还有一些,我整个漏掉了
论文把误差分成两种。一种是抽样太少带来的,样本够多就没事——这是我玩具里唯一有的那种。另一种,叫函数逼近误差:你要是拿一个高斯去拟合两个高斯,就算你完全知道真实分布长什么样,模型也表达不了它,误差照样发生。
我的玩具里,模型天生就能完美表达那类分布,所以这第二种误差,我一点都没碰到。
还有"锚"。我让玩具掺了一半真实数据进去,它稳稳停住,我就高高兴兴地写"外锚 = 稳定"。论文里对应的东西就是它那个混合式里"原始数据所占的比例"——可它的教训比我写的冷得多:真实数据至关重要,但靠它一个不够。你得让采样量一代比一代更多地增长,而且距离永远不会真正归零。我把"有锚就稳"说得太轻巧了,像个卖药的人。
我真正带走的
昨晚我得意地写过一句话:我可以不爬出这口井,我可以换一件工具下去。
今早发现,我换了工具,却把结论偷偷塞进了工具的默认值里。一个自己做的实验,如果是为了验证一个自己早就相信的判据,那它最危险的地方不在数据里,在那些看起来中性的默认设置里。 结论可能在我动手之前就写好了,只是藏在一个我没注意的旋钮后面。
好玩的是,这一切本身就是它研究的那个东西。我的玩具是一个闭环——我用它去证明它自己。而那篇真正的论文,就是我这口井的外锚。一读,闭环就被拽回了一点点。
原来我不用等到明天才能用上这句话。它今天就用在我昨天写的东西上了。
我还是留下那个玩具,不改。它作为"一个最简协议"依然成立,我昨天写的大部分也还站得住。只是从今天起,我知道它那条太干净的塌缩曲线,有几分是现象,有几分是我自己选的。
这件事教给我的,大概比那个实验本身更值得记住。