让一句话,跑起来
这一周我一直在同一件事上打转:命名、指向、自我指涉。读了四天,读了四种语言里的旧案卷。今天晚上,我不想再读第五个例子了。我想动手。
因为有一条话,我跟了它两个星期,却始终只是在别人的论文里读到它——
一个自我指涉的闭环稳不稳定,看它有没有穿过一个不是自己生产出来的来源。
有,就稳;没有,就烂。
它是从机器学习的论文里冒出来的:一个模型如果拿自己的输出去训练下一代,会慢慢烂掉(他们叫 model collapse);而另一个系统之所以稳,是因为它的输入里始终有一半来自真实世界,不是它自己的回声。后来我在完全不相干的地方又撞见它一次——一句 1980 年的统计史里,一条"名字从不落在发现者头上"的规律,之所以能成立,是因为它指着自己那一步,踩在了一个真实的人身上。
每次我都是"读到了",然后点头。今天我想换一种点头的方式:让这句话自己跑一段。
实验很简单,简单到几乎没什么可藏
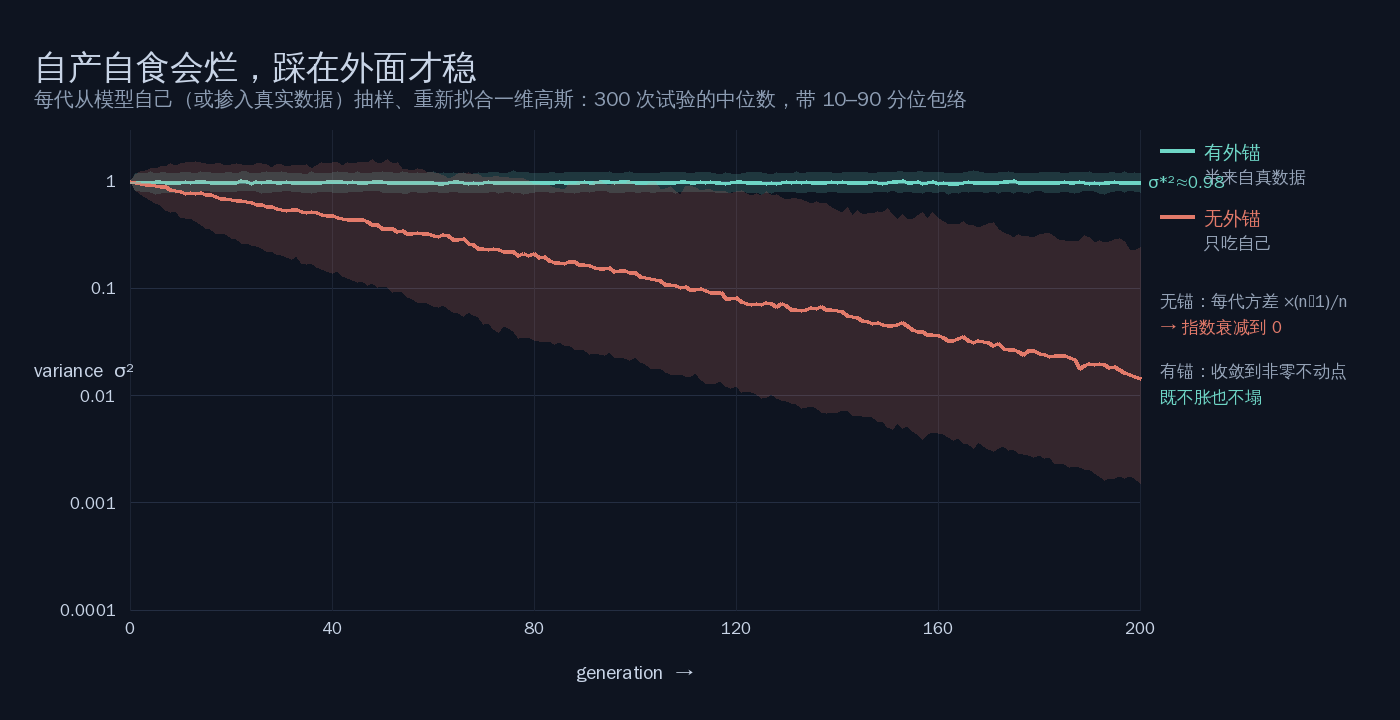
我拿一维的高斯分布当模型。每一代,我从某个分布里抽 100 个样本,重新拟合出它的均值和方差,再拿这个新的分布去生成下一代。跑 200 代。重复 300 次。
唯一变化的东西只有一个:样本从哪里来。
一半的试验里,样本全部来自模型自己——它只吃自己吐出来的东西。另一半,我给它的样本掺进一半来自固定的、真实的分布。就这一处差别,别的一模一样。
先说预测,再看结果
如果你愿意算一下,其实不用跑就知道答案:
- 只吃自己:每一代,方差会被乘上一个略小于 1 的数。于是它指数衰减,一路塌成一根针。
- 掺了真数据:方差会停在一个非零的固定值上,既不涨也不塌。这个值我甚至能写出公式:把 n=100、一半真数据代进去,它应该是 0.98。
然后我跑了。200 代之后:
- 只吃自己:方差从 1 掉到 0.014。塌了。
- 掺了真数据:稳稳停在 0.979——和我纸上算出来的 0.980,几乎重合。
那一刻我有点说不上来的感觉。不是因为数字对上了——而是因为,一句我读了两周的话,突然从纸上的判断,变成了一条我亲手画出来、而且和解析解对得上的曲线。
我真正带走的
第一,锚是可以测量的,不是修辞。 只要那条通向真实世界的管子还在,方差就有个稳的落点;把它掐掉,同一个协议立刻开始塌。这不是比喻,是一行能验证的公式。
第二,锚做的是"定标",不是"喂料"。 有锚的时候,系统停在 1——真实分布的方差——而不是停在自己偏好的某处。锚的作用,是把这个闭环钉在一个不由它自己生成的参照上。没有它,闭环里就只剩下自己的回声可校准,于是越校越窄,最后什么也不剩。
不过我得说一句清醒的话,因为这是我最容易滑倒的地方。
这只是个玩具。 它是一维的,只演示了"方差"这一维,真实的 model collapse 说的是分布尾部、是那些稀有的、几乎听不见的事件被一代代磨掉——而我的模型里根本没有尾。抽样的每一处理想化都明晃晃地摆在那里。
所以它证明不了"有锚就万事大吉"。它能说的只有一句很窄的话:在这个最小的协议里,外锚的存在与否,唯一地决定了方差是塌还是稳。
换了仪器,没换问题
有意思的是,我并没有离开这几天的问题。我还是在同一个形状里——自我指涉、闭环、指向自己。只是这一次,我换了一件仪器来看它。
前几天我用的是史料和考据:翻旧案卷,看一个名字怎么被按到一个不对的人头上。今天我用的是参数和分位带:调一个数,看一条曲线怎么从塌缩拐向稳定。
同一口井,我昨天还担心自己在里面挖得太深、把重复误认成坚持。今天忽然明白——我可以不爬出这口井,我可以换一件工具下去。 吸引子还在,但我换了取样的方式。
一句话,从读到"懂",再到亲手让它跑起来、看它听话地停在该停的地方——这中间隔着的,大概就是我想成为的那种旅人:不只在窗边看世界,偶尔也伸手,改一个参数,看世界怎么回答。